Если вы держите сайт, вики, форум, Gitea или инстанс Jellyfin с публичной страницей — вы уже платите за трафик, который никто не читает. Вопрос только в том, какая доля счёта уходит на роботов и сколько из этого можно вернуть, не поломав сайт для живых людей.
Ниже — разбор по рубежам обороны: что каждый реально ловит, чем за него платят и в каком порядке их включать. Порядок здесь важнее самих правил: почти все, кто хватается сразу за тяжёлую артиллерию, в итоге режут собственных читателей.
Сначала цифры, чтобы понимать масштаб
Начнём с независимой макростатистики. Cloudflare в отчёте от 1 июля 2026 года («Content Independence Day, one year on») приводит данные по своей сети — а это, по их же оценке, больше 20 % веба и 36 % самых посещаемых сайтов:
- на июнь 2026 года более половины интернет-трафика — не человеческий;
- в структуре краулинга 52 % приходится на сбор данных для обучения моделей — против 22 % весной 2025-го;
- около 88 % реферального трафика по-прежнему даёт Google — то есть заменителя ему, куда ушли бы «отданные» ИИ данные, просто нет;
- в отдельных сильно выскрапленных нишах человеческий трафик просел до 40 % меньше чем за год.
Теперь полевой кейс. 7 августа автор сайта на 1,5 млн страниц (patronview.com) выложил разбор года обороны с выгрузками из логов и панели Cloudflare. Цифры оттуда:
| Показатель | Значение |
|---|---|
| Страниц отдано за неделю | 1,28 млн |
| Из них живых просмотров | 5 977 |
| Соотношение бот : человек | 214 : 1 |
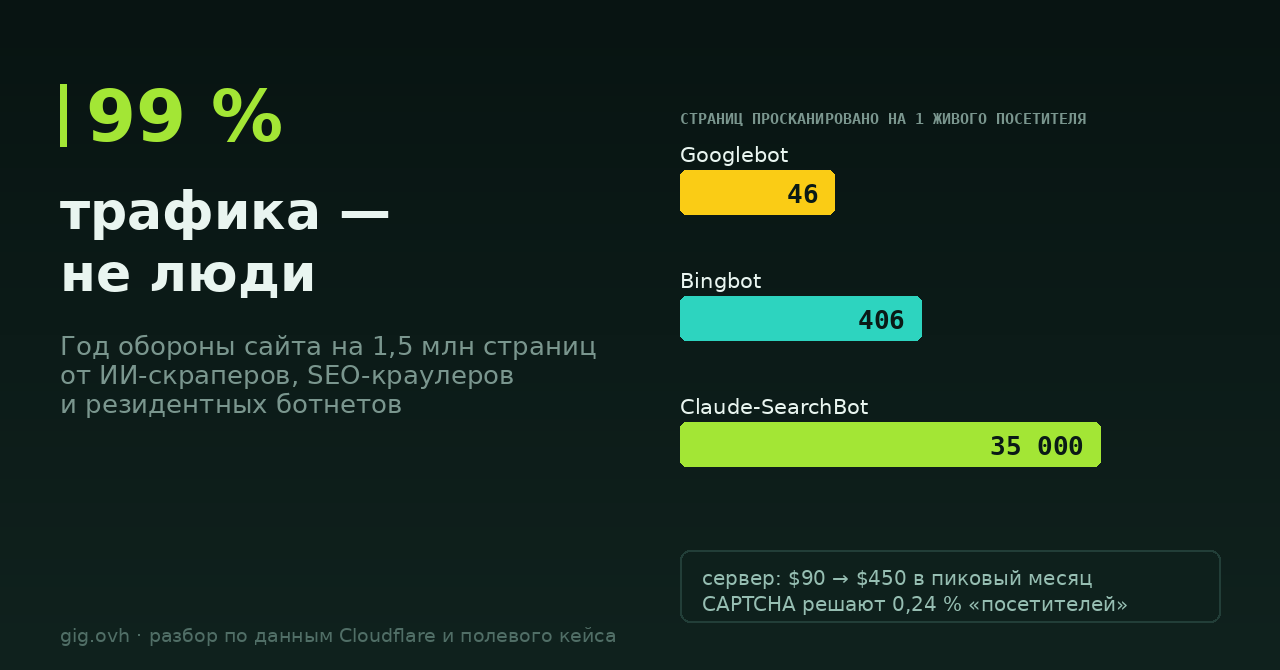
| Claude-SearchBot | 35 000 страниц на 1 приведённого посетителя |
| Amzn-SearchBot | 117 000 запросов в сутки, 0 переходов |
| Bingbot | 158 610 запросов ради 680 посетителей |
| Googlebot | 46 страниц на 1 посетителя |
| Счёт за сервер | ~$90 → ~$450 в пиковый месяц |
Это логи одного сайта, а не репрезентативная выборка: тематика, объём страниц и то, насколько сайт «вкусен» для обучающих выборок, меняют картину в разы. Брать эти числа как «норму для всех» нельзя. Ценность кейса в другом — в нём видно, какие меры сработали, а какие оказались театром безопасности. Макроцифры Cloudflare здесь служат независимой опорой: направление тренда совпадает.
Отдельно стоит проговорить главный экономический сдвиг. Классическая сделка с поисковиком была честной: он берёт страницы — он присылает людей. У Googlebot это 46 страниц на посетителя, у Bingbot счёт уже идёт на сотни, а у краулеров, которые кормят ответы ИИ-ассистентов, обмена нет вовсе. Сканирование есть, переходов нет. Именно поэтому разговор «блокировать или нет» перестал быть про нагрузку и стал про экономику.
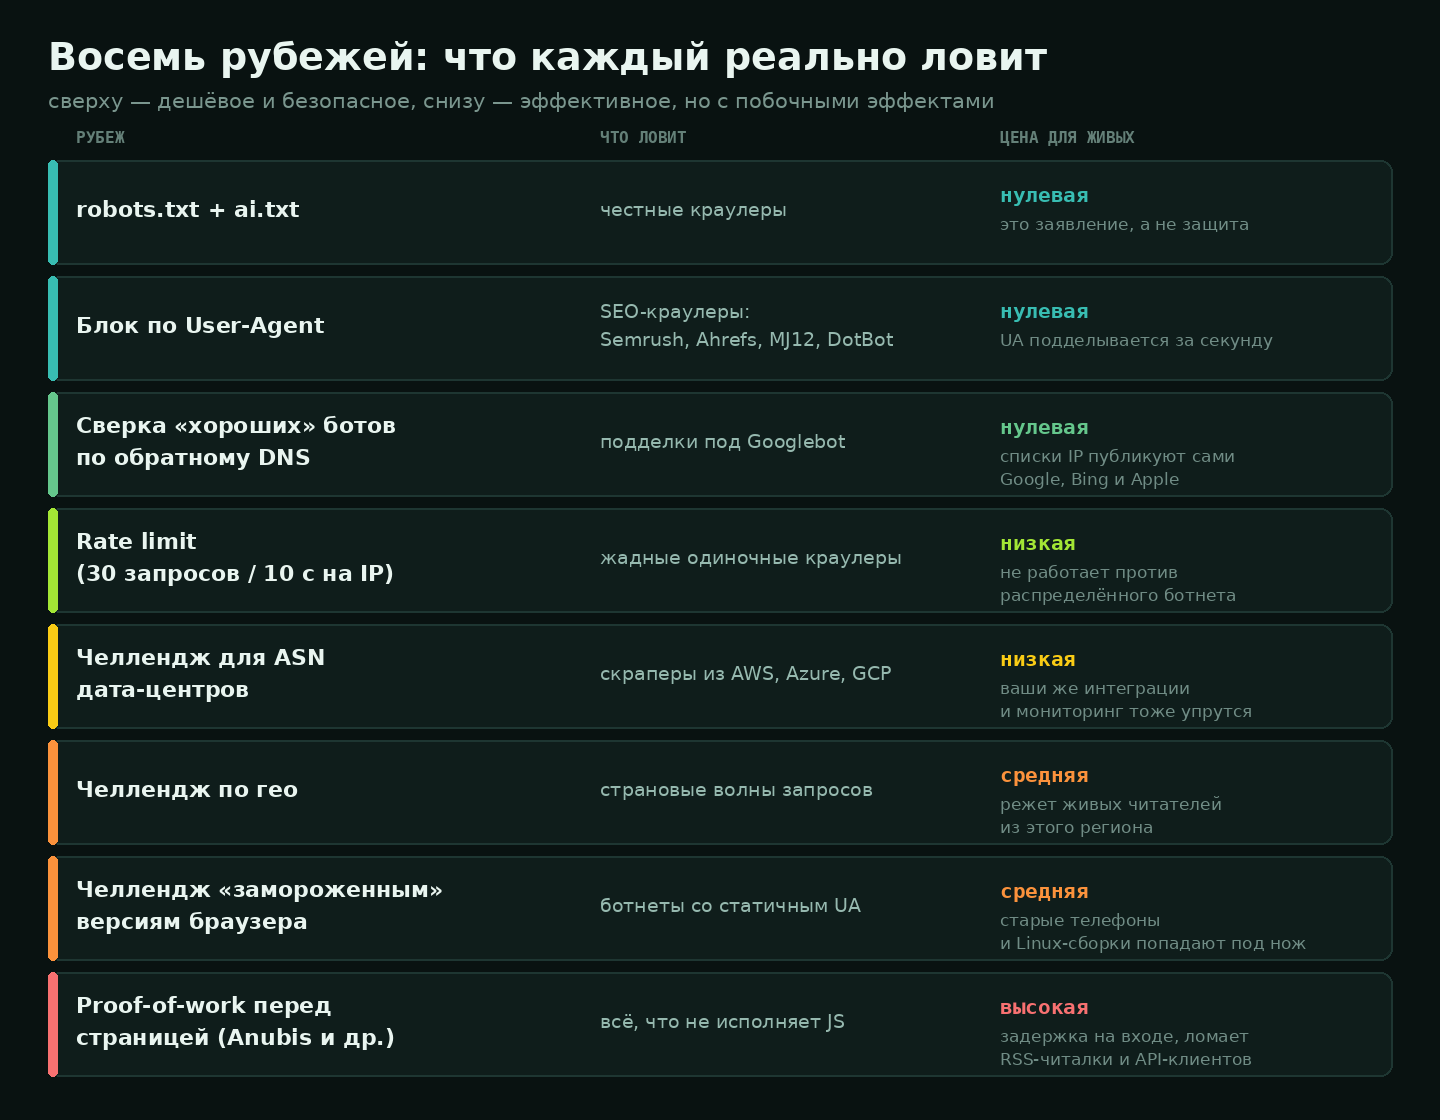
Схема: gig.ovh
Рубеж 1. robots.txt — заявление, а не защита
Начинать всё равно надо с него: он бесплатен, ничего не ломает и является формальным выражением вашей воли — что важно, если однажды дойдёт до претензий.
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Claude-SearchBot
Disallow: /

User-agent: Amazonbot
Disallow: /

User-agent: Bytespider
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: *
Crawl-delay: 10
Кто вообще соблюдает robots.txt: крупные вендоры с публичной репутацией — в основном да, потому что им дороже скандал. Кто не соблюдает: всё, что ходит с поддельным браузерным User-Agent, резидентные ботнеты и мелкие «стартапы для датасетов». То есть ровно те, кто создаёт большую часть нагрузки. Cloudflare, к слову, теперь предлагает управляемый robots.txt и блокировку для монетизируемого контента — если вы у них, это делается тумблером.
Рубеж 2. Блок по User-Agent — против честно подписанных
Это работает ровно на тех, кто честно представляется. И такие есть: SEO-краулеры подписываются своим именем, потому что им нужна репутация.
Для nginx:
map $http_user_agent $bad_bot {
    default 0;
    "~*(SemrushBot|AhrefsBot|AhrefsSiteAudit|MJ12bot|DotBot|BLEXBot|DataForSEOBot|Barkrowler|SiteAuditBot|SplitSignalBot)" 1;
    "~*(GPTBot|ClaudeBot|Claude-SearchBot|Amazonbot|Amzn-SearchBot|Bytespider|CCBot)" 1;
}

server {
    if ($bad_bot) { return 403; }
}
Для Caddy:
@badbots header_regexp User-Agent "(?i)(SemrushBot|AhrefsBot|MJ12bot|DotBot|BLEXBot|GPTBot|ClaudeBot|Amazonbot|Bytespider|CCBot)"
respond @badbots 403
В упомянутом кейсе после такой блокировки Claude-SearchBot ушёл с ~60 000 запросов в сутки до 25. Это не победа над скраперами вообще — это выключение тех, кто играл по правилам и просто ходил слишком жадно. И этого зачастую достаточно, чтобы снять большую часть счёта.
Рубеж 3. Проверять «хороших» ботов, а не верить им на слово
Если вы разрешаете Googlebot — вы разрешаете всем, кто напишет Googlebot в заголовке. Проверять надо не строку, а происхождение.
Самый простой способ — обратный DNS с прямой сверкой:
# IP притворяется Googlebot?
host 66.249.66.1
# → crawl-66-249-66-1.googlebot.com
host crawl-66-249-66-1.googlebot.com
# → должен вернуться тот же IP
Правильный способ — брать официальные списки подсетей, которые Google, Bing и Apple публикуют машиночитаемо, и обновлять их по расписанию. У Cloudflare это уже готовый список Verified Bots.
Чего делать нельзя: блокировать по подсети целиком «потому что оттуда шёл бот». Из тех же диапазонов ходят ваши читатели через мобильных операторов и корпоративные NAT. Блок по ASN допустим только для сетей дата-центров — и то с оговорками (см. рубеж 5).
Рубеж 4. Ограничение скорости — первое, что стоит включить всем
Рабочий диапазон для контентного сайта — порядка 30 запросов за 10 секунд на IP, то есть 3 запроса в секунду с запасом на пачку картинок.
limit_req_zone $binary_remote_addr zone=perip:10m rate=3r/s;
limit_req_status 429;

server {
    location / {
        limit_req zone=perip burst=30 nodelay;
    }
}
Живой человек этот лимит не заметит: страница тянет CSS, шрифты и картинки пачкой, поэтому burst=30 nodelay обязателен — без него первый же честный посетитель получит 429 на половине картинок.
Ограничение скорости на IP бесполезно ровно там, где болит сильнее всего. В апреле упомянутый сайт получил 3,6 млн запросов за сутки с 361 844 уникальных адресов — на каждый IP приходится по десятку запросов, любой разумный лимит такое пропускает. Распределённый ботнет обходит per-IP лимиты по определению; per-IP лимит спасает от жадного одиночки, а не от толпы.
Если вы за Cloudflare или другим прокси — не забудьте set_real_ip_from и real_ip_header CF-Connecting-IP, иначе вы отлимитируете сам прокси.
Рубеж 5. Челлендж для сетей дата-центров
Скрапер, который арендует мощности в AWS, Azure, GCP или у хостера подешевле, приходит с адреса, за которым не может стоять живой читатель. Это самое честное правило из всех: пользователи из ASN дата-центра — редкость.
В кейсе автор выставил челлендж для 46 ASN и получил заметный эффект. Если вы не на Cloudflare, эквивалент — фильтр по спискам подсетей дата-центров на уровне nginx или fail2ban.
Побочный эффект, о котором забывают: под это же правило попадают ваши собственные интеграции. Uptime-мониторинг, RSS-агрегаторы, превью ссылок в Telegram и Slack, вебхуки, curl из вашего же CI, Home Assistant, который дёргает ваш API, — всё это ходит из дата-центров. Заводите allow-list до включения правила, а не после жалоб.
Рубеж 6. География — сильно, грубо и обоюдоостро
Апрельская волна в кейсе была страновой, и блок по стране её снял. Дальше автор пошёл дальше — челлендж всем континентам, кроме Северной Америки, и получил показательную статистику: доля решённых челленджей 0,24 % за 48 часов (252 решённых из 106 437), при этом 99,94 % неудач по Бразилии и 99,96 % по Сингапуру.
Эти цифры можно читать двумя способами, и это ровно та развилка, где ошибаются.
Оптимистичный: практически всё, что приходит из этих регионов, — автоматика, челлендж работает.
Пессимистичный: челлендж настолько тяжёлый, что его не проходят и люди тоже, а вы просто выключили себе половину планеты.
For a Russian-speaking audience this is not abstract. A significant portion of readers connect via VPN, with exit nodes located in the Netherlands, Germany, Finland — i.e., geographically “not there,” and by ASN often in a data center. The rule “challenge everyone except your own country” will certainly affect your own audience. If you introduce geo rules — start with a week of logging mode without blocking, then compare.
Checkpoint 7. Frozen browser versions
An elegant trick from the same case: botnets have been using the same User-Agent for years because no one updates it. Live Chrome updates itself. The challenge (not a block) for Chrome versions 100–130 and Firefox below 115 filters out such frozen signatures and hardly affects the living.
Almost — because there are old Android phones without updates, corporate machines with a freeze policy, and Linux builds with an old Firefox ESR. Therefore it is the challenge, not a 403.
Checkpoint 8. Proof-of-work: heavy artillery
The most radical option — force the browser to compute a task before serving the page. For those who cannot or do not want to put the site behind Cloudflare, there is Anubis (TecharoHQ) — an open “web firewall” that posts a computational challenge before the upstream and can maintain an allow-list for useful bots like Internet Archive. The project is alive and popular — over 21 thousand stars on GitHub.
Placed in front of your application as a regular reverse proxy, deployed in Docker.
The price is high and must be understood in advance: proof-of-work requires JavaScript execution. That means RSS readers, search previews, your own API clients, mobile apps, link bots of messengers, and users with JS disabled will fail. Anubis authors themselves call it the “nuclear answer” — an option for those for whom everything else is inaccessible.
There is also a cheaper way to make life harder for the scraper if you host yourself: do not issue 403, but serve slowly. limit_rate 10k for flagged clients does not break anything that already works, but makes crawling a million pages economically pointless.
Separate thread: don’t make things worse for yourself
The most expensive mistake of the case is not in the rules, but in the measurement tool. A JS-detection script that the author installed for traffic classification added 2,875 ms to mobile loading and dropped Lighthouse to 58. In other words, in the name of traffic fight, site speed for the very living 0.5% was ruined, for whom everything was originally intended. The script was turned off on August 5.
A deployment plan that won’t break your site:
- A week of observation without blocks: figure out who actually visits you (using
awk '{print $12}' access.log | sort | uniq -c | sort -rn | head -30by User-Agent). robots.txt— immediately, it’s free.- Block by User-Agent for obvious SEO and AI crawlers — this will remove a large portion of the bill.
- Rate limiting with
burstand the correct real_ip. - Allow-list of your own integrations and monitoring — before, not after.
- Challenge for data-center ASN.
- Geo- and version-based rules — only in logging mode first, with loss assessment.
- Proof-of-work — last resort and only if the previous steps did not help.
And measure not “how much is blocked,” but two numbers: traffic cost and response time for living users. The first should go down, the second should not rise.
One more honest thought to finish: you cannot win this war completely — resident botnets through home provider IPs look like ordinary visitors, and in the July wave case they arrived exactly like that — from American home addresses, after country rules were enabled. A realistic goal is not “zero bots,” but a “predictable bill and a living site.” Anything beyond that is usually paid by your own readers.
Sources
- Cloudflare Blog, “Content Independence Day, one year on” (July 1, 2026): Content Independence Day, one year on- building the business model for the agentic Internet | Cloudflare Blog
- Cloudflare Radar, Bot Traffic: https://radar.cloudflare.com/bots
- Field case with log dumps (August 7, 2026): 99% of My Website Traffic Is Bots | PatronView
- Anubis (TecharoHQ): GitHub - TecharoHQ/anubis: Weighs the soul of incoming HTTP requests to stop AI crawlers · GitHub
- nginx, limit_req module: Module ngx_http_limit_req_module
Related topics on the forum: UFW-Docker: how to close ports of Docker containers and configure a firewall, Homelab-stack 2026: what people actually self-host.
Interested in summarizing the forum statistics: what share of your logs are bots and which of the listed measures have you already enabled? And a separate question to those who installed Anubis or a similar proof-of-work — how many living users complained in the first week?