14 августа Google опубликовала в своём блоге по безопасности пост о HEIR — компиляторе, который берёт обученную модель и превращает её в код, работающий поверх зашифрованных данных. Сервер получает шифртекст, крутит его через слои сети, отдаёт шифртекст обратно — и ни на одном шаге не имеет физической возможности посмотреть, что там внутри. Расшифровать может только тот, у кого ключ, то есть сам пользователь.
Звучит как маркетинговый слайд, поэтому сразу уточню: сам HEIR не новость. Он лежит на GitHub с 2023 года, под Apache-2.0, и это давно не секретный проект. Новое в августовском посте — заявка на то, что этим наконец можно пользоваться, не будучи криптографом, плюс четыре собранных демо и список железных партнёров. Ниже — разбор того, что реально происходит внутри такого компилятора, потому что без этого невозможно понять, где у гомоморфного шифрования проходит граница применимости.
Гомоморфное шифрование в одном абзаце. Обычное шифрование — это ящик, который надо открыть, чтобы что-то сделать с содержимым. Гомоморфное — ящик с перчатками: вы просовываете руки внутрь и складываете, умножаете, сравниваете, не открывая крышку. Полностью гомоморфные схемы (FHE) поддерживают и сложение, и умножение неограниченное число раз, чего достаточно, чтобы выразить любое вычисление.
Слой 1. Функция, у которой аргументы помечены как секретные
Точка входа выглядит обманчиво просто. Разработчик пишет обычную функцию, помечает типы тех аргументов, которые нельзя раскрывать, и отдаёт это компилятору. Внутри HEIR это превращается в MLIR-диалект secret — представление, которое ещё ничего не знает про криптографию. Оно говорит только: «вот здесь идёт вычисление над значением, которое сервер видеть не должен».
Разделение на «схемо-независимый» и «схемо-зависимый» уровни — вся суть проекта. Именно оно позволяет один и тот же исходник прогнать через разные криптосистемы и сравнить, что получится.
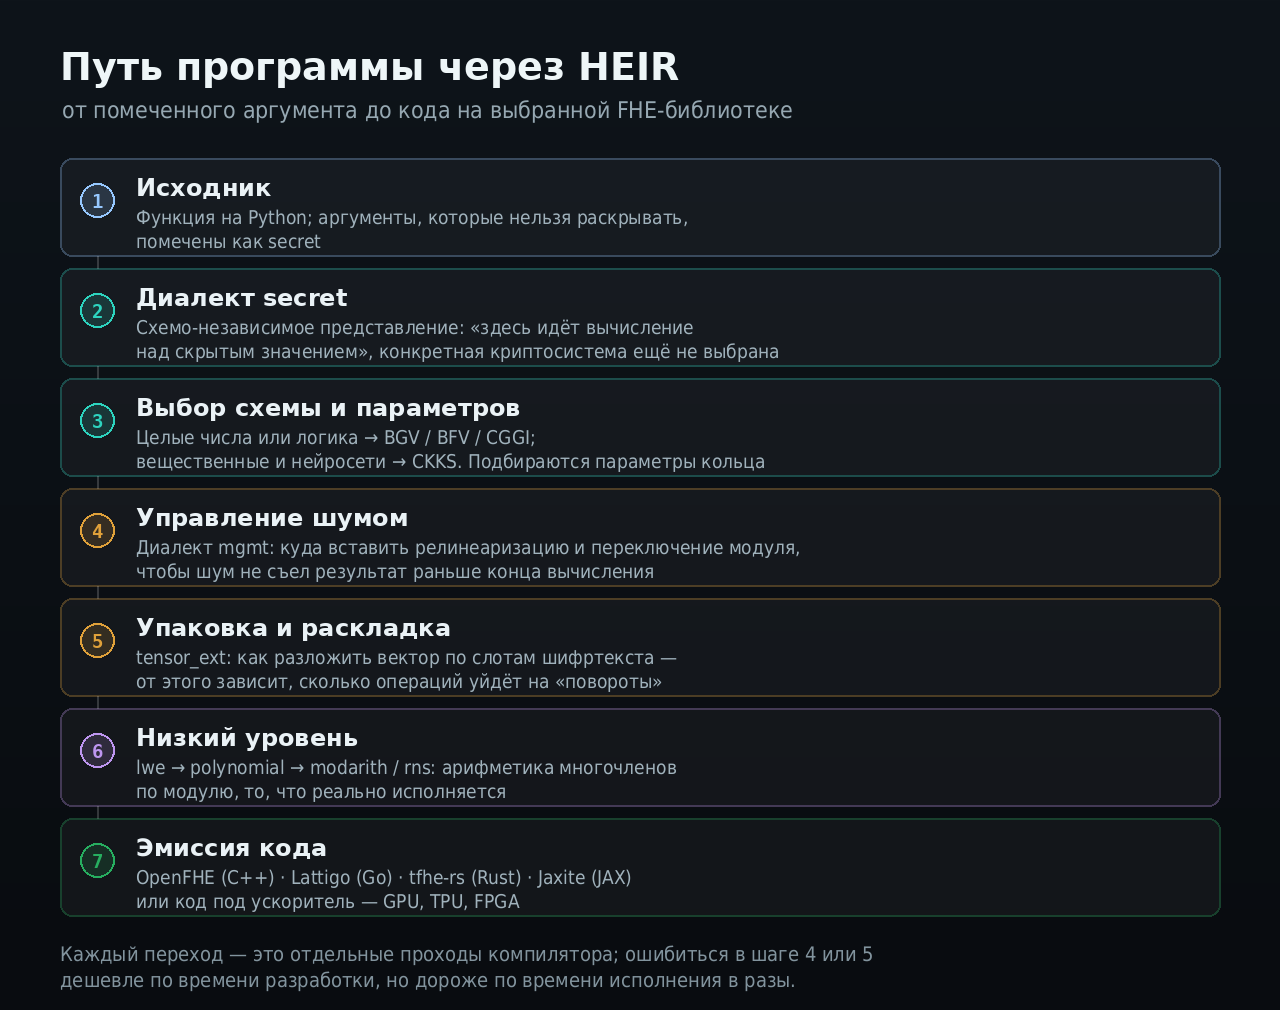
Схема на основе документации heir.dev (раздел Design) и описания диалектов в репозитории google/heir
Слой 2. Развилка схем: почему их четыре, а не одна
Дальше компилятор выбирает криптосистему, и это не вопрос вкуса. У каждой схемы своя арифметика и свои сильные стороны:
| Схема | Что умеет естественно | Типичное применение |
|---|---|---|
| BGV / BFV | точная арифметика над целыми числами | подсчёты, агрегации, SQL-подобные операции |
| CKKS | приближённая арифметика над вещественными | нейросети, статистика, ML-инференс |
| CGGI (TFHE) | побитовая логика, быстрый bootstrapping | сравнения, ветвления, произвольные булевы схемы |
Модель машинного обучения почти всегда уезжает в CKKS: там числа с плавающей точкой ложатся на схему естественно, ценой того, что результат получается приближённым. Если же в задаче нужны честные сравнения и ветвления — это территория CGGI.
Слой 3. Шум — расходный материал, который заканчивается
Вот место, где красивая идея начинает упираться в физику. Любой шифртекст в этих схемах несёт в себе небольшой случайный шум, без которого шифрование не было бы стойким. Каждая операция шум увеличивает: сложение — чуть-чуть, умножение — заметно. Когда шум перерастает порог, расшифровка даёт мусор.
Поэтому компилятор занимается не столько «переводом», сколько бюджетированием. В HEIR за это отвечает отдельный диалект mgmt, и его задача — расставить по программе служебные операции:
- релинеаризацию — после умножения шифртекст «распухает», его надо сжать обратно;
- переключение модуля (modulus switching) — сбросить часть накопленного шума ценой уменьшения оставшегося запаса;
- bootstrapping — самую дорогую операцию, которая обнуляет шум и позволяет считать дальше сколь угодно долго.
Именно шумовой бюджет, а не «медленная математика» сама по себе, определяет, влезет ли ваша задача в FHE. Программа, которую можно посчитать без единого bootstrapping, и программа, которой он нужен на каждом слое, отличаются по времени исполнения не на проценты, а на порядки.
Слой 4. Упаковка: раскладка данных решает больше, чем выбор схемы
Один шифртекст в BGV и CKKS — это не одно число, а вектор из тысяч «слотов». Можно упаковать в него сразу целый батч, и тогда одна операция обрабатывает тысячи значений разом. Но операции применяются к слотам поэлементно, и как только вам нужно сложить соседей, приходится делать циклический сдвиг вектора — отдельную и недешёвую операцию.
За это в HEIR отвечает диалект tensor_ext. Он решает, как разложить тензор по слотам, чтобы свёртка или матричное умножение потребовали минимума поворотов. Это ровно та работа, которую при ручной реализации FHE люди делают неделями и в которой чаще всего и ошибаются.
Слой 5. Бэкенд: чужие библиотеки и чужое железо
На выходе HEIR не исполняет ничего сам — он генерирует код под существующие реализации. Матрица поддержки из репозитория выглядит так:
| Библиотека | Язык | BGV | BFV | CKKS | CGGI |
|---|---|---|---|---|---|
| OpenFHE | C++ |  |
|
|
— |
| Lattigo | Go | |
|
|
— |
| tfhe-rs | Rust | — | — | — | |
| Jaxite | JAX | — | — | — | |
Отдельная линия — ускорители. В посте перечислены Belfort, Niobium, Cornami и Optalysys: компании, которые делают железо специально под FHE. Академический список тоже длинный — Georgia Tech, CMU, UC Santa Barbara, Purdue, Эдинбург, Цинхуа и другие; на HEIR, по данным Google, уже построены четыре рецензируемые публикации.
Что показывают четыре демо
Google выложила четыре примера, скомпилированных через HEIR:
- Рекомендательная модель DLRM — совместно с Belfort Labs, LG и NYU.
- Детектор мошеннических транзакций по картам — с Niobium и hardshell.ai.
- Обнаружение сетевых вторжений на базе системы Kitsune — аномалии ищутся без раскрытия содержимого пакетов.
- Детектор ключевого слова в аудио — снова с Belfort Labs.
Общий знаменатель у всех четырёх один: небольшая модель, фиксированная архитектура, инференс без обучения. Это честный выбор — именно такие задачи сегодня и влезают в FHE.
Сценарий с Kitsune стоит отдельного внимания для тех, кто занимается сетями: IDS, которая ищет аномалии, не разбирая содержимое трафика, снимает главное возражение против облачных систем обнаружения вторжений — «вы отдаёте провайдеру весь свой трафик».
Чего в анонсе нет
А теперь неприятная часть, ради которой стоило всё это разбирать.
В посте от 14 августа нет ни одной цифры производительности. Ни времени инференса, ни сравнения с открытым текстом, ни размера ключей, ни объёма трафика. Указано лишь, что все четыре демо считались на одном ядре CPU. Ближайший публичный ориентир от самой Google — пост 2023 года, где для трёхслойной нейросети, скомпилированной из TensorFlow Lite, назывался приватный инференс за 16 секунд.
16 секунд на трёхслойную сеть — это не «медленно», это другой класс задач. FHE сегодня не заменяет обычный инференс, а открывает те сценарии, где сама передача открытых данных на сервер невозможна по закону или по договору, и где ответ можно подождать.
Второе, о чём в анонсе сказано вскользь: заявленная цель — «решение в один клик для неспециалистов». Это цель, а не текущее состояние. Свежий тег релиза в репозитории — v2026.07.01, кодовая база почти поровну состоит из C++ и MLIR, и порог входа там соответствующий. Собрать MLIR-тулчейн и подобрать параметры кольца — всё ещё занятие для человека, который понимает, что такое шумовой бюджет.
И третье, о чём почти никогда не пишут в анонсах FHE: гомоморфное шифрование прячет данные, но не прячет факт и форму вычисления. Сервер видит, что вы обратились, сколько это заняло, какого размера шифртекст и какую именно модель вы прогоняете. Метаданные и трафик-анализ остаются в силе, и в модели угроз это надо учитывать отдельно.
Кому это стоит потрогать сейчас
Если у вас продакшен — почти наверняка рано. Если вам интересно, как выглядит вычисление, которое нельзя подсмотреть, — уже вполне можно: репозиторий открыт, демо собираются, документация по диалектам есть.
Разумный порядок знакомства:
github.com/google/heir— сам компилятор и примеры пайплайнов.github.com/google/fully-homomorphic-encryption— репозиторий с демо.- Раздел Design на heir.dev — описание диалектов, анализа шума и упаковки; читается как учебник по тому, из чего вообще состоит FHE-компилятор.
Отдельно отмечу, что не вошло в текст: вокруг темы много обзоров вида «топ-N FHE-решений», которые хостятся на доменах самих вендоров ускорителей. Ни одной независимо подтверждённой цифры производительности HEIR я в них не нашёл, поэтому в статье их нет.
Источники
- How Google is making private AI practical with homomorphic encryption — блог Google, 14 августа 2026
- github.com/google/heir — репозиторий компилятора, Apache-2.0
- heir.dev — Design — описание диалектов и проходов
- Expanding our fully homomorphic encryption offering — Google Developers Blog, 2023, откуда цифра про 16 секунд
- github.com/google/fully-homomorphic-encryption — демо-репозиторий
А где бы вы согласились платить секундами и мегабайтами за то, чтобы сервер физически не мог прочитать ваши данные? Медицинские выборки, банковский скоринг, поиск по логам у подрядчика — или пока это всё выглядит академической игрушкой?